
AI 모델 학습과 LLM 추론용 GPU를 구성할 때 GeForce RTX 5070 Ti와 NVIDIA RTX PRO 4000 Blackwell 중 어떤 제품이 더 적합한지 비교해 보았습니다.
두 제품 모두 NVIDIA의 최신 Blackwell 아키텍처를 기반으로 하지만, 제품의 성격은 상당히 다릅니다.
RTX 5070 Ti는 높은 연산 성능과 가격 대비 성능을 중시한 소비자용 GPU이며, RTX PRO 4000 Blackwell은 더 큰 VRAM과 ECC 메모리, 워크스테이션 안정성을 중시한 전문가용 GPU입니다.
1. 주요 사양 비교
| 구분 | RTX 5070 Ti | RTX PRO 4000 Blackwell |
|---|---|---|
| 아키텍처 | NVIDIA Blackwell | NVIDIA Blackwell |
| CUDA Core | 8,960 | 8,960 |
| Tensor Core | 5세대 | 5세대 |
| RT Core | 4세대 | 4세대 |
| VRAM | 16GB GDDR7 | 24GB GDDR7 ECC |
| 메모리 버스 | 256-bit | 192-bit |
| 메모리 대역폭 | 약 896GB/s | 약 672GB/s |
| ECC 메모리 | 지원하지 않음 | 지원 |
| PCIe | PCIe 5.0 | PCIe 5.0 |
| 소비전력 | 약 300W | 약 140W급 |
| 주요 용도 | 게임, AI 학습, CUDA | AI, CAD, 워크스테이션, 서버 |
| 드라이버 | Game Ready / Studio | NVIDIA RTX Enterprise |
가장 눈에 띄는 차이는 VRAM 용량입니다.
RTX 5070 Ti는 16GB의 GDDR7 메모리를 제공하지만 RTX PRO 4000 Blackwell은 24GB GDDR7 ECC 메모리를 제공합니다.
반면 메모리 대역폭과 전력 제한을 고려하면 RTX 5070 Ti는 순수 연산 성능 측면에서 상당히 강력합니다.
2. 딥러닝 학습에서는 RTX 5070 Ti가 유리
YOLO, CNN, DETR과 같은 Computer Vision 모델을 학습하는 경우에는 RTX 5070 Ti의 가격 대비 성능이 매우 뛰어납니다.
예를 들어 다음과 같은 작업입니다.
- YOLO 객체 탐지 학습
- DETR 기반 객체 탐지
- CNN 이미지 분류
- Segmentation
- 이미지 기반 Transformer
- PyTorch CUDA 학습
RTX 5070 Ti는 높은 메모리 대역폭과 충분한 CUDA 연산 성능을 가지고 있기 때문에 일반적인 Computer Vision 모델을 학습하기에는 매우 좋은 선택입니다.
특히 16GB VRAM 안에서 모델과 Batch Size를 구성할 수 있다면 RTX PRO 4000보다 RTX 5070 Ti의 가격 대비 성능이 더 좋을 수 있습니다.
추천
YOLO, DETR, CNN 등 영상 AI 학습이 주목적이라면 RTX 5070 Ti를 추천합니다.
3. LLM에서는 RTX PRO 4000의 24GB VRAM이 큰 장점
LLM에서는 단순한 GPU 연산 성능보다 VRAM 용량이 매우 중요합니다.
모델의 Parameter뿐만 아니라 다음 데이터들도 GPU 메모리를 사용하기 때문입니다.
- Model Weight
- KV Cache
- Activation
- Attention 연산
- Context Length
- Batch Size
- LoRA / QLoRA 학습 데이터
따라서 16GB와 24GB의 차이는 실제 LLM 활용에서 상당히 크게 느껴질 수 있습니다.
대략적인 활용 범위는 다음과 같습니다.
| 작업 | RTX 5070 Ti 16GB | RTX PRO 4000 24GB |
|---|---|---|
| 7B LLM 추론 | 매우 적합 | 매우 적합 |
| 12B~14B 모델 | 가능 | 여유 있음 |
| 20B급 Quantized 모델 | 메모리 제약 | 상대적으로 유리 |
| 30B급 Quantized 모델 | 매우 제한적 | 조건부 가능 |
| LoRA | 가능 | 유리 |
| QLoRA | 가능 | 유리 |
| vLLM | 가능 | 더 큰 KV Cache 확보 |
| Long Context | 제한적 | 상대적으로 유리 |
특히 vLLM에서는 GPU 메모리 일부를 KV Cache로 사용하기 때문에 8GB의 VRAM 차이가 동시 사용자 수나 Context Length에 직접적인 영향을 줄 수 있습니다.
추천
Gemma, Llama, Phi, GPT-OSS 계열 LLM을 실행하거나 vLLM 기반 추론 서버를 운영한다면 RTX PRO 4000 24GB가 더 유리합니다.
4. RTX PRO 4000의 중요한 장점: ECC Memory
RTX PRO 4000 Blackwell의 또 하나의 장점은 ECC(Error Correcting Code) 메모리입니다.
ECC 메모리는 GPU 메모리에서 발생할 수 있는 일부 Bit Error를 감지하고 수정하는 기능입니다.
일반적인 개인용 AI 개발에서는 ECC가 반드시 필요한 것은 아니지만 다음과 같은 환경에서는 의미가 있습니다.
- 24시간 AI 서버
- 장시간 모델 학습
- 연구용 워크스테이션
- 기업용 AI 서버
- 대규모 데이터 처리
- 안정성이 중요한 시스템
따라서 서버 안정성을 중요하게 생각한다면 RTX PRO 계열이 더 적합합니다.
5. 두 GPU를 함께 사용하면 어떨까?
AI 개발용 워크스테이션에서는
RTX 5070 Ti 16GB + RTX PRO 4000 24GB
구성도 상당히 좋은 조합입니다.
예를 들어 다음과 같이 역할을 분리할 수 있습니다.
RTX 5070 Ti 16GB
        │
        ├─ YOLO 학습
        ├─ DETR 학습
        ├─ CNN
        └─ Computer Vision

RTX PRO 4000 24GB
        │
        ├─ LLM
        ├─ vLLM
        ├─ RAG
        ├─ Multi-Agent
        └─ AI 추론 서버
이 방식의 장점은 서로 다른 작업이 GPU 자원을 경쟁하지 않는다는 점입니다.
예를 들어 RTX 5070 Ti에서는 YOLO를 학습하면서 RTX PRO 4000에서는 LLM 추론 서버를 동시에 실행할 수 있습니다.
6. PyTorch에서 두 GPU 확인하기
Ubuntu 환경에서 PyTorch를 사용하는 경우 다음과 같이 GPU를 확인할 수 있습니다.
import torch

print("GPU Count:", torch.cuda.device_count())

for i in range(torch.cuda.device_count()):
    print(i, torch.cuda.get_device_name(i))
정상적으로 인식되면 다음과 같이 표시될 수 있습니다.
GPU Count: 2

0 NVIDIA GeForce RTX 5070 Ti
1 NVIDIA RTX PRO 4000 Blackwell
7. GPU를 지정해서 프로그램 실행하기
특정 GPU에서 프로그램을 실행하려면 CUDA_VISIBLE_DEVICES를 사용할 수 있습니다.
RTX 5070 Ti에서 AI 학습
CUDA_VISIBLE_DEVICES=0 python train.py
또는 YOLO를 사용하는 경우
yolo detect train \
model=yolo11m.pt \
data=data.yaml \
epochs=100 \
device=0
RTX PRO 4000에서 LLM 실행
CUDA_VISIBLE_DEVICES=1 \
vllm serve MODEL_NAME
이와 같이 두 GPU의 역할을 명확하게 나누면 GPU 활용 효율이 높아집니다.
8. 16GB + 24GB = 40GB GPU가 되는 것은 아니다
듀얼 GPU 구성에서 가장 많이 오해하는 부분입니다.
RTX 5070 Ti 16GB와 RTX PRO 4000 24GB를 설치하면 전체 GPU 메모리는 물리적으로 40GB가 됩니다.
하지만 일반적인 CUDA 프로그램에서는 이것이 자동으로 하나의 40GB GPU처럼 동작하지 않습니다.
GPU 0
RTX 5070 Ti
VRAM 16GB

+

GPU 1
RTX PRO 4000
VRAM 24GB

≠

40GB 단일 GPU
대신 모델 병렬화(Model Parallelism)나 Tensor Parallelism을 사용하는 경우 여러 GPU에 모델을 나누어 올릴 수 있습니다.
예를 들어 vLLM, Hugging Face Accelerate, DeepSpeed 등의 프레임워크를 활용할 수 있습니다.
다만 16GB와 24GB처럼 서로 다른 GPU를 혼합할 경우 동일 GPU 두 장을 사용하는 것보다 메모리 분배와 성능 최적화가 복잡해질 수 있습니다.
9. 용도별 추천
| 용도 | 추천 GPU |
|---|---|
| YOLO 학습 | RTX 5070 Ti |
| CNN 학습 | RTX 5070 Ti |
| DETR 학습 | RTX 5070 Ti |
| 이미지 분류 | RTX 5070 Ti |
| 7B LLM | 둘 다 |
| 14B LLM | RTX PRO 4000 |
| 20B급 LLM | RTX PRO 4000 |
| QLoRA | RTX PRO 4000 |
| vLLM 서버 | RTX PRO 4000 |
| RAG 시스템 | RTX PRO 4000 |
| Multi-Agent LLM | RTX PRO 4000 |
| 장시간 AI 서버 | RTX PRO 4000 |
| 게임 | RTX 5070 Ti |
| CAD / 전문 그래픽 | RTX PRO 4000 |
10. 결론
두 GPU는 단순히 어느 제품이 더 좋은가로 비교하기보다는 용도에 따라 선택해야 합니다.
RTX 5070 Ti
RTX 5070 Ti는 높은 연산 성능과 메모리 대역폭을 가지고 있어 YOLO, DETR, CNN과 같은 딥러닝 모델 학습에 매우 적합한 GPU입니다.
16GB VRAM 안에서 모델을 실행할 수 있다면 가격 대비 AI 학습 성능이 매우 뛰어납니다.
RTX PRO 4000 Blackwell
RTX PRO 4000 Blackwell은 절대적인 연산 성능보다는 24GB VRAM, ECC 메모리, 낮은 소비전력, 워크스테이션 안정성이 강점입니다.
따라서 LLM, vLLM, RAG, Multi-Agent 시스템이나 장시간 AI 서버를 구축하는 경우 더 적합합니다.
개인적인 AI 워크스테이션 구성
두 GPU를 모두 활용할 수 있다면 다음과 같은 구성이 효율적입니다.
┌─────────────────────────────┐
│       AI Workstation        │
├─────────────────────────────┤
│ RTX 5070 Ti 16GB            │
│                             │
│ YOLO / CNN / DETR           │
│ Computer Vision Training    │
├─────────────────────────────┤
│ RTX PRO 4000 24GB           │
│                             │
│ LLM / vLLM / RAG            │
│ Multi-Agent / AI Server     │
└─────────────────────────────┘
결국 영상 AI 학습은 RTX 5070 Ti, LLM과 AI 서버는 RTX PRO 4000으로 역할을 나누는 것이 매우 효율적인 구성이라고 볼 수 있습니다.
현재 5070 Ti + PRO 4000 듀얼 GPU 구성이 정말 매력적 인것 같습니다.
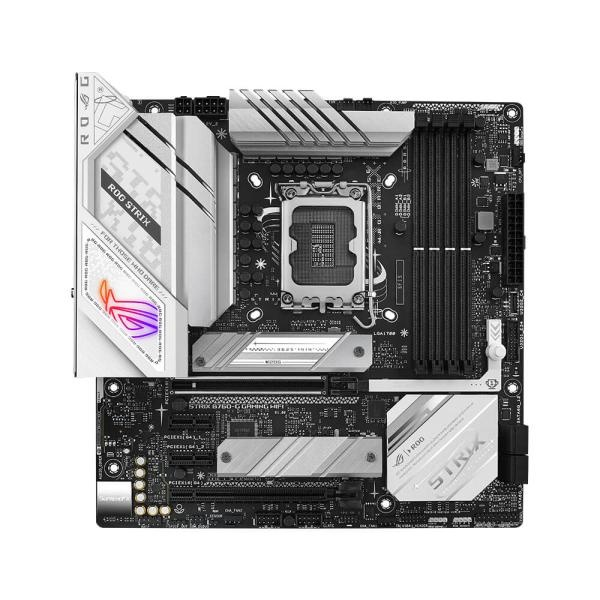
참고로 메인보드는 [ASUS] ROG STRIX B760-G GAMING WIFI 코잇 (인텔B760/M-ATX) 사용 중 입니다.
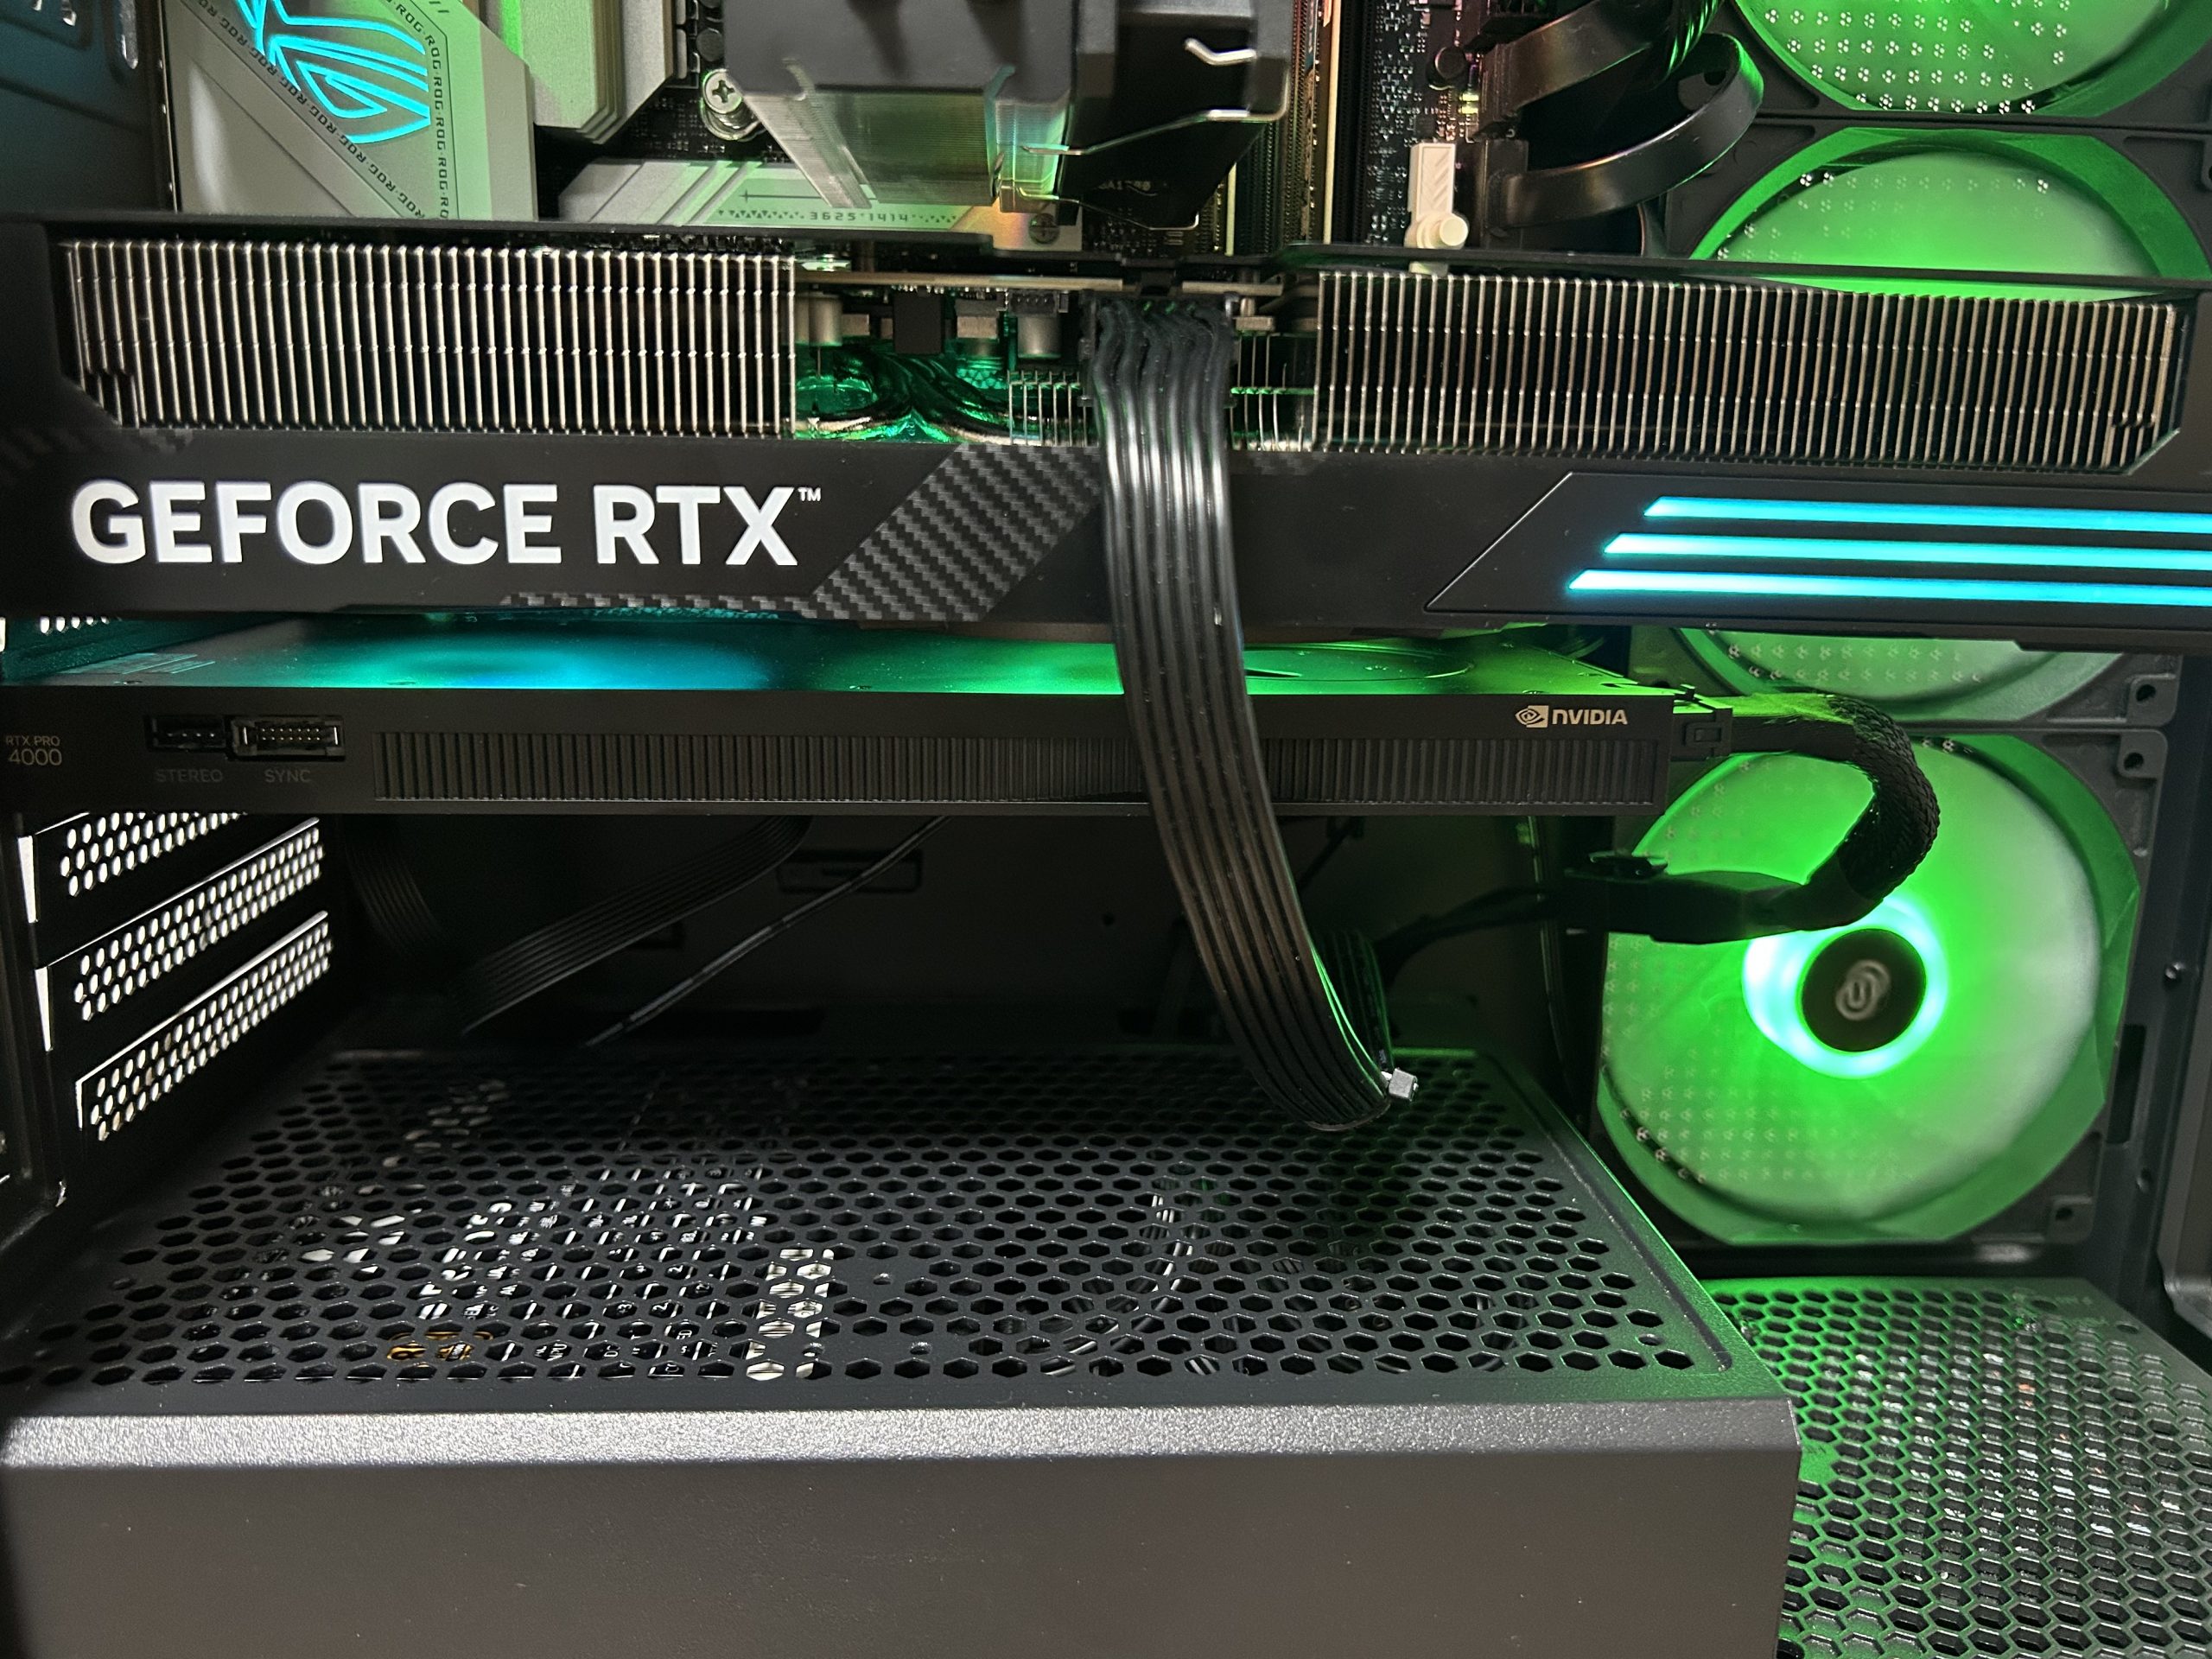
드디어 RTX PRO 4000 + RTX 5070 ti 2way 설치하는데 성공했습니다.

